

三菱UFJ信託銀行がデータ基盤「MUTBデータクラウド」の構築に着手してから3年。Snowflakeの利用者は約50人から1000人超へと拡大し、現在では全10事業のうち8事業が何らかの形で利用するまでに広がった。
だが、同社が目指しているのはデータ基盤の利用拡大だけではない。生成AIの浸透によって、これまで別々に進めてきたデータ活用とナレッジマネジメントが結びつき始めている。分析に長けた社員の「暗黙知」をAIを通じて組織に残す――そんな取り組みも視野に入ってきた。
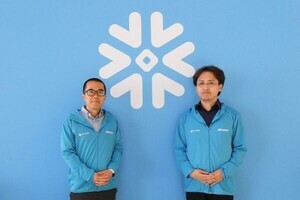
この取り組みを進めてきたのが、同社デジタル戦略部の西潟裕介氏だ。成果が認められ、「Snowflake Data Superheroes」に金融機関として日本で初めて選出された。
-

三菱UFJ信託銀行 デジタル戦略部 西潟裕介氏

今年6月に米サンフランシスコで開催された「Snowflake Summit 2026」で西潟氏に、3年間の取り組みと、その先に見据えるAI時代のデータ活用について聞いた。


3年で利用者数20倍、8割の事業に浸透
三菱UFJ信託銀行がSnowflakeの導入に着手したのは2023年7月。機密性の低い外部データや市場データから使い始め、1つの事業の個別ユースケースへの対応からスタートした。2024年度にはStreamlitやNotebookによるセルフ分析環境を整え、リテールなど機密性の高いデータにも対応できるよう体制を整備した。この時期の社内利用者は50人程度だったという。
2025年度に入ると、生成AIアプリケーションの開発や営業店向けBIダッシュボードとの連携が始まり、利用者数は1000人を突破。全10事業のうち8事業が何かしらの形でSnowflakeを使う状態まで裾野が広がった。そして今年度は、AIエージェントの業務活用と全社的なデータマネジメントの拡大を掲げているという。
利用拡大の背景にあるのが、「完璧な仕組みを最初から用意しない」という考え方だ。全社の要件を最初に定義するのではなく、将来を見据えつつも、まずは機密性の低いデータから着手し、3カ月ごとのサイクルで扱える範囲を広げてきた。
こうした広がりは、現場の小さな作業の変化としても表れている。従来、担当者の端末上でExcelやVBAを使っていた分析もSnowflake上で共有することで、他部署へ展開しやすくなったという。
興味深いのは、8割の事業に利用が広がった現在でも、Snowflakeに載せているデータは全体のごくわずかにすぎないことだ。「全部を載せようとは思ってない」と西潟氏は明かす。信託銀行が扱うデータは、提案書や契約書、年金の規約文書といった非構造なものが大半を占め、活用のめどが立っている構造化データも限られる。だからこそ、経営指標や横断的に利用するデータを優先し、必要が生じた事業から利用を広げる。データをすべて集約することよりも、使われることを優先してきたことが、結果として利用者の拡大につながった。
「一番重たいところ」に合わせない、金融機関のデータ基盤
段階的な展開を支えているのが、金融機関ならではの厳格なリスク管理だ。三菱UFJ信託銀行では、新しい機能がリリースされるたびに、約200項目に及ぶ独自のセキュリティチェックリストを用いて安全性を確認している。
このような徹底したリスク管理は、事業ごとに異なる制約とも密接に関わっている。三菱UFJ信託銀行には、自己資金を運用する部門と、顧客から預かった資産を運用する部門があり、両者のデータは厳格に分けて管理しなければならない。
Snowflakeが新機能をリリースするたびに、そうした事業間の壁を越えてデータが混ざってしまわないかなど、都度確認する必要があるという。
だからといって、全社を一律に慎重なペースへ合わせるわけではない。「一番重たいところに引きずられるやり方を取ると、進まなくなってしまう」と西潟氏。機密性の低いデータを扱う事業には先に進んでもらい、機密性の高いデータを扱う事業には相応の時間をかけてリスクを整理する。事業ごとに異なる速度で走らせながら、全体としては足並みを止めないというのが、同社の考え方だ。

"できる人"のやり方が、AIに残っていく
同社がこれまで進めてきたナレッジマネジメントは、契約書のチェックや社内業務の一部など、比較的形式知化しやすい領域が中心だった。
西潟氏が期待を寄せるのは、これとは別の種類のナレッジだ。例えば、データ分析。分析の得意・不得意には「かなり個人差がある」と西潟氏は語る。つまり、同じ機能を使っても引き出せる価値には差が出る。分析が得意な社員がなぜ精度の高い結果を出せるのか、その勘所は文書として残るものではなく、これまで言語化の糸口がなかった領域だという。
SnowflakeのAIエージェント機能「CoWork」について、西潟氏は、あらかじめデータを整えておけば、SQLの知識がなくても自然言語で必要な情報を引き出せるようになると期待を寄せる。例えば、役員から急に取引状況の報告を求められた際、これまでのようにチームがその都度データを集める作業を減らせる可能性がある。
だが、西潟氏がより注目しているのが、CoWorkに搭載されたメモリ機能だ。これはユーザーとのやり取りを踏まえて応答がパーソナライズされていくという新機能。この機能を利用すれば、分析が得意な社員とAIとのやり取りをメモリとして蓄積し、後から構造化することで、「この判断はチームとして残していこう」という形で他の社員も参照できるようになる。これまで手が届かなかった「分析の暗黙知」を形式知化できる可能性があるという。
これが実現すれば、若手社員の育成にも良い影響が期待できると西潟氏は見る。業務のノウハウを十分に持たない若手や異動してきた社員でも、AIとの対話を通じて有識者の知見にアクセスできるからだ。西潟氏はこれを「壁打ちしていきながらついてくれる家庭教師」のような存在と表現する。
一方で、これまで社員が試行錯誤を重ねる中で身につけてきた分析スキルについては、AIが手助けすることで「それを身につけるタイミングが失われる」可能性もあるという。AIの活用を前提に、育成のあり方そのものを組み替えていく必要性を感じているという。
もっとも、あらゆる暗黙知が同じように形式知化できるわけではない。契約書のように形式が定まったもの、分析のように糸口が見え始めたものがある一方で、依然として手つかずの領域も残っている。西潟氏が「まだ思うように進んでいない」と明かすのが、法人・個人営業の領域だ。契約書とは異なり、法人・個人営業の領域にはそもそも唯一の正解がない。判断の背景を形式知に落とし込もうとしても、そもそも表出化が困難なケースが多いと西潟氏は語る。この点は今後の課題となりそうだ。
データ基盤だけでは「AX」には届かない
西潟氏に今後の抱負を聞くと、「データの民主化を広めていきたい」と語った。まずは自社、さらに金融機関全体、そして比較的保守的とされる日本の他業種にも広げていきたいという。
「DXからAX」への方向性の変化が語られるなか 、西潟氏は、データ活用にAIが織り込まれていく世界観になってきていると見る。ただし、それはデータマネジメントと、暗黙知を継承するナレッジマネジメントが結びついて初めて実現するもので、基盤を導入しただけでは届かない領域があるという。一方で、こうした取り組みを積み重ねることで、以前では考えられなかったデータ活用に近づいてきたという手応えも感じている。
西潟氏は今後も先端的な取り組みについて情報発信を続け、「日本全体のDX・AXの前進に、少しでも貢献していきたい」と語った。


 OpenAIとAnthropic、AIサブスクの利用上限を見直し - 背景に推論コスト