

今回は、リンク切れを検出するツールを作ってみよう。再帰の仕組みさえ分かっていれば、思ったよりも簡単に作ることができるので、Pythonでいろいろなツールを作りたいという人にはピッタリの題材とも言える。しかし、作る際によく考えないといけない注意ポイントも多いので確認してみよう。
-
リンク切れチェッカーを作ってみよう

リンク切れ検出ツールはどうやって作る?
Webサイト同士はリンクでつながっていて便利だ。しかし、リンク先が消滅してしまったり、ページ構造が変わってしまうなどの都合で、リンク切れになることがある。
リンク切れを放置してしまうと、ユーザーの利便性が下がるだけでなく、検索エンジン(SEO)の評価にも悪影響を及ぼす可能性がある。それで、定期的にチェックして修正することが大切になるのだが、ページ数が多くなると手動で確認するのは大変だ。そこで活躍するのが「リンク切れチェッカー」だ。
なお、既存のツールを使うのも良いのだが、Webサイトの構造は複雑怪奇であり、特定の条件でチェックしたい場合も多い。そのため、自作のチェッカーを作るなら、効率よくリンク切れをチェックできるだろう。
しかし、この手のツールを何も考えずに作ると大変なことになる。どんな点について考えるべきか、簡単に図で確認してみよう。
-
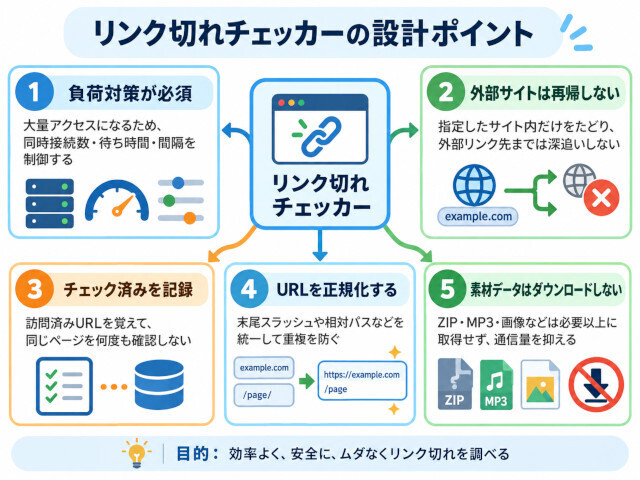
リンク切れチェッカー作成のポイント

ぱっと見ただけでは、なぜ必要なのか分からないと思うので、以下の点を一つずつ詳しく見ていこう。
(1) サーバーへ大量アクセスを行うので負荷対策が必須
(2) 指定のサイト以外は再帰チェックしないようにする
(3) チェック済みのページを覚えておく
(4) URLの正規化を行う
(5) 素材データはダウンロードせず存在確認だけする
サンプルのリンク切れチェッカーの使い方
最初に、完成品を確認しておこう。プログラム一式を、こちらにアップロードしている。プログラム全体が見たい場合は、そちらを参照しよう。
それで、ここで利用するのは、定番のPythonライブラリの「requests」と「beautifulsoup4」だ。ターミナル(WindowsならPowerShell、macOSならターミナル.app)を開いて、次のコマンドを実行してインストールしておこう。
pip install requests beautifulsoup4
ちなみに、「requests」はURLを指定してファイルをダウンロードするライブラリで、「beautifulsoup4」はHTMLを解析するライブラリだ。
それで、プログラムを実行するには、次のようなコマンドを実行しよう。
python link_checker.py https://example.com
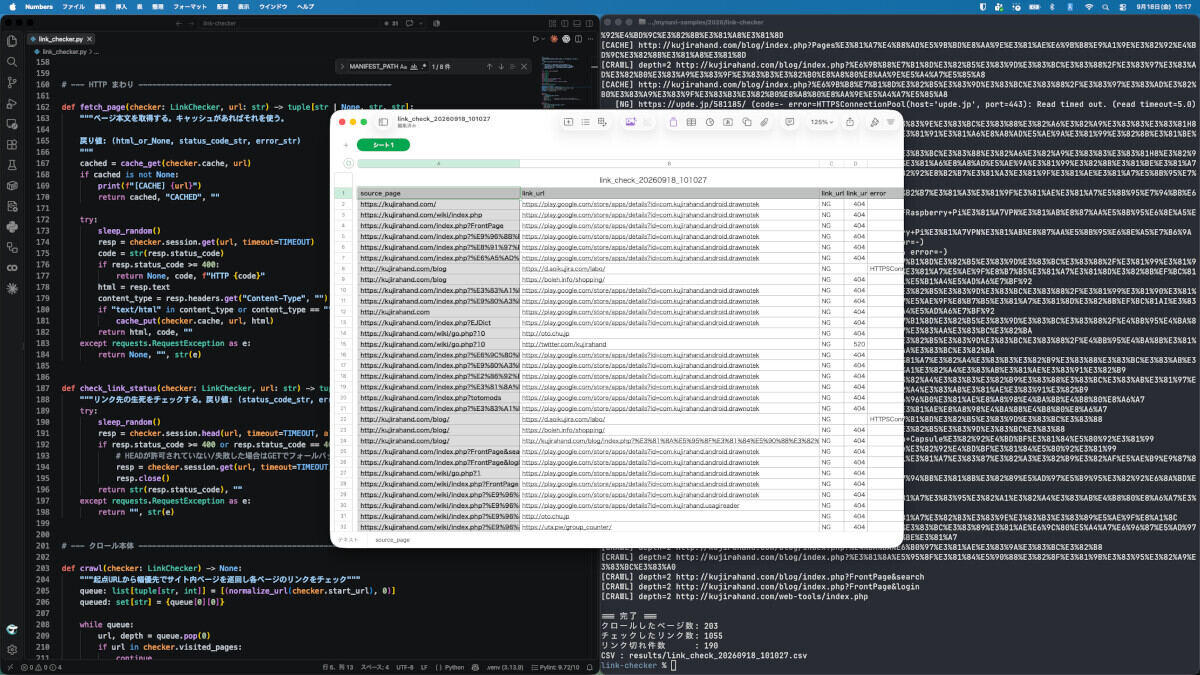
すると、次のようなレポートを表示して、CSVファイルを作成する。
クロールしたページ数: 100
チェックしたリンク数: 250
リンク切れ件数      : 3
CSV : results/link_check_20260918_112344.csv
そして、CSVファイルを表計算ソフトで開くと、次のように、リンクの検証結果をみることができる。
それでは、冒頭で挙げた注意ポイントを中心に、コードを交えて確認してみよう。
ポイント(1) サーバーへの負荷対策が必要
まず、リンクチェッカーでは、Webサイトからリンクの一覧を抽出し、そのリンクを一つずつ開いていくのだが、再帰的にリンクをたどるので、かなりのWebアクセスを行うことになる。
リンク切れチェッカーが大量のアクセスを行うので、時間をかけてゆっくりチェックするよう配慮することが大切になる。
そこで、一度アクセスしたら数秒の間隔を開けると良いだろう。短時間に大量のリクエストを送ると、Webサイトへの不正なアクセスや攻撃を検知・遮断する仕組みであるWAFのレート制限に引っかかり、429や403などが返される場合がある。また、最悪の場合には、サーバーからDoS攻撃と誤認されてしまう。そのため、特に重要なので忘れないように実装しよう。
それで、今回のプログラムは、次のように、sleep_random()という関数を定義して、ファイルをダウンロードするタイミングで、この関数を呼び出すようにしている。
WAIT_TIME = (1.0, 3.0)  # リクエスト間の待機秒数の範囲(最小, 最大)

def sleep_random() -> None:
    """ランダムに待機し、サーバーへの負荷を抑える"""
    min_wait, max_wait = WAIT_TIME
    time.sleep(random.uniform(min_wait, max_wait))
そして、実際にファイルをダウンロードする関数は次のように、最初に必ずsleep_random()関数を呼ぶようにしている。なお、このページ取得関数には、キャッシュ機能を持たせているので、複数回プログラムを実行したときに、何度もサーバーにアクセスしないようにしている。
def fetch_page(checker: LinkChecker, url: str) -> tuple[str | None, str, str]:
    """ページ本文を取得する。キャッシュがあればそれを使う"""
    cached = cache_get(checker.cache, url)  # キャッシュの確認
    if cached is not None:
        print(f"[CACHE] {url}")
        return cached, "CACHED", ""

    try:
        sleep_random() # ← 必ず待機してサーバー負荷を下げる
        resp = checker.session.get(url, timeout=TIMEOUT)  # urlを取得
        code = str(resp.status_code)
        if resp.status_code >= 400:  # サーバーが返すステータスコードを確認
            return None, code, f"HTTP {code}"
        html = resp.text
        content_type = resp.headers.get("Content-Type", "")
        if "text/html" in content_type or content_type == "":
            cache_put(checker.cache, url, html)
        return html, code, ""
    except requests.RequestException as e:
        return None, "", str(e)
ポイント(2) 指定のサイト以外は再帰チェックしない
リンクというのは自分のサイトの中だけでなく、サイトの外にもリンクしているため、自分のサイト外を確認するときは、再帰的に確認しないようにする必要がある。
以下はページを取得した後、HTMLからリンクを抽出して、再帰的にページを取得するため、キューにページを追加している部分だ。
# HTMLをパースしてリンクを抽出し、チェックおよびキューへの追加を行う
soup = BeautifulSoup(html, "html.parser")  # HTMLをパース
# <a>タグを取り出して繰り返す
for a_tag in soup.find_all("a", href=True):
    # …省略…
    # URLを正規化して絶対URLに変換
    link_url = normalize_url(urljoin(url, raw_href))
    # …省略…
    # リンクの存在をチェックして結果を記録
    check_and_record(checker, link_url, source_page=url)
    # 内部リンクであればキューに追加して再帰的にクロール
    if is_internal(checker, link_url) and depth + 1 <= checker.max_depth:
        if link_url not in checker.visited_pages and link_url not in queued:
            queue.append((link_url, depth + 1))  # キューに追加
            # …省略…
上記のプログラムのように、is_internal()関数を使って、指定のURLが内部リンクかどうかを確認して、内部リンクのときだけ、その先のページを取得するようにしている。
そして、内部リンクかどうかを判定する関数is_internal()は次のように定義している。
def is_internal(checker: LinkChecker, url: str) -> bool:
    """起点URLと同じドメインかどうかを判定する(サイト内リンクの再帰対象判定に使用)"""
    return urlparse(url).netloc == checker.base_domain
ポイント(3) チェック済みのページを覚えておく
そして、リンクを巡回するのに必要なのが、チェック済みのページを覚えておくことだ。
というのは、ページAからページBにリンクしているだけでなく、ページBからページAにもリンクしていることがある。あるいは、A→B→C→Aのように、別のページBとCを経由して再びAに戻ってくることがある。そのため、一度チェックしたページを覚えておいて、何度も訪問しないようにしよう。
今回のプログラムで、リンク巡回を行う関数が次のcrawl()だ。ここでは、リスト型の変数queueを利用して、訪問済みかどうかをチェックするようにしている。
def crawl(checker: LinkChecker) -> None:
    """起点URLから幅優先でサイト内ページを巡回し各ページのリンクをチェック"""
    queue: list[tuple[str, int]] = [(normalize_url(checker.start_url), 0)]
    queued: set[str] = {queue[0][0]}

    while queue:
        url, depth = queue.pop(0)
        if url in checker.visited_pages:  # 既に巡回済みなら除外する
            continue
        checker.visited_pages.add(url)  # 巡回済みに追加

        print(f"[CRAWL] depth={depth} {url}")
        # ...省略...
ポイント(4) URLの正規化を行う
URLには「#section1」のようなフラグメントが付く場合がある。フラグメントは同じHTML内の位置を示すものなので、リンクチェックでは同一ページとして扱うことができる。この処理のために、Python標準ライブラリのurllib.parseの関数urldefragを使う。
さらに、HTMLのリンクは、「../index.html」や「../s1/s2/page.html」のように相対パスで記述されている場合がある。そのため、リンク元のURLを基準にして、絶対URLへ変換する必要がある。この処理にはurllib.parse.urljoin()関数を利用できる。
例えば、次のように記述する。
from urllib.parse import urljoin, urldefrag

# 基本URLを指定
base_url = "https://example.com/docs/page.html"

# 相対URLを絶対URLに変換
url = urljoin(base_url, "../index.html#section1")
print(url)  # https://example.com/index.html#section1

# `#`以降のフラグメントを取り除く
url, fragment = urldefrag(url)
print(url)  # https://example.com/index.html
print(fragment) # section1
ポイント(5) 素材データはダウンロードせず存在確認だけする
最後に、ZIPファイルや画像、音声ファイルなどの素材データは、実際にダウンロードしないようにしたい。この処理は必須でないものの、この処理を加えることで、通信量を抑えることができる。
このために、次のようなコードを書いた。URLを小文字にして、パスの末尾を確認するだけだ。
EXCLUDE_EXTENSIONS = (
    ".pdf", ".jpg", ".jpeg", ".png", ".gif", ".zip", ".svg",
    ".ico", ".mp4", ".mp3")  # ダウンロードしない拡張子を指定

def is_excluded(url: str) -> bool:
    """ダウンロード対象外かどうかを判定する"""
    path = urlparse(url).path.lower()
    return path.endswith(EXCLUDE_EXTENSIONS)
また、自分以外が管理するサイトをクロールする場合は、サイトごとのルール「robots.txt」を確認したり、サイトの利用条件も確認する必要があることを覚えておこう。
まとめ
以上、今回は、リンク切れチェッカーを作ってみた。仕組みは単純なものの、気をつけるべきポイントがいくつもあるので、実用的なツールを作成するには、意外と頭を使うことだろう。
今回、サンプルとして作ったのは、基本的なリンク切れチェックができるものになっているので、これに特定のURL以下のパターンを除外する機能を追加するなど、いろいろな機能をつけて、自分のサイトチェック用にカスタマイズしてみると良いだろう。
なお、JavaScriptによって動的にレンダリングされるページもあるが、今回のプログラムでは、これに対応していない。これに対応するには、ブラウザを直接操作する必要がある。そのために、Playwrightなどのライブラリを利用することになる。これを使う場合にも、考え方は同じなので、改造してみるのもオススメだ。
自由型プログラマー。くじらはんどにて、プログラミングの楽しさを伝える活動をしている。代表作に、日本語プログラミング言語「なでしこ」 、テキスト音楽「サクラ」など。2001年オンラインソフト大賞入賞、2004年度未踏ユース スーパークリエータ認定、2010年 OSS貢献者章受賞。技術書も多く執筆している。直近では、「実践力をアップする Pythonによるアルゴリズムの教科書(マイナビ出版)」「シゴトがはかどる Python自動処理の教科書(マイナビ出版)」「すぐに使える!業務で実践できる! PythonによるAI・機械学習・深層学習アプリのつくり方 TensorFlow2対応(ソシム)」「マンガでざっくり学ぶPython(マイナビ出版)」など。


 「Windows 11が速くなった」ユーザーの声、Microsoftは今秋さらなる改善へ


