Rustでいろいろなアルゴリズムを実装する本連載ですが、今回は「ブルームフィルタ(Bloom Filter)」を紹介します。ブルームフィルタの使いどころは、大量のデータの中に、任意のデータが存在しないことを確認したい場面です。検索対象のデータが少ない時は、データを逐次検索すれば良いのですが、対象データが膨大な場合に、圧倒的なパフォーマンスで「絶対ない」ことを判定できます。Webブラウザの危険URLの判定や、データベースのパフォーマンス向上などで活用されています。それでは、Rustで実装してみましょう。
-
ブルームフィルタをRustで実装してみよう

ブルームフィルタの仕組み―データを持たずに「旗」だけを立てること
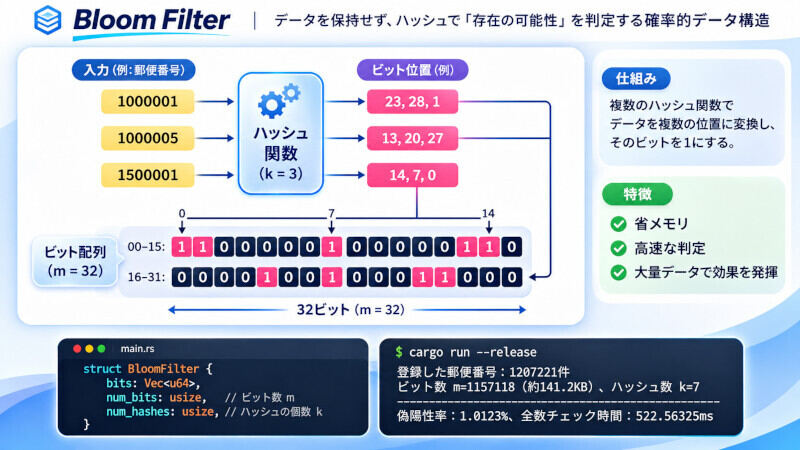
確率的データ構造「ブルームフィルタ」は、データそのものを保存するのではなく、そのデータを位置に変換して旗を立てることで、データが存在するかを判定するアルゴリズムです。その特徴は、省メモリで高速に判定できることです。データ量が大量になればなるほど真価を発揮します。
ブルームフィルタの仕組みを単純化して確認してみましょう。たとえば、32ビットのデータ(0と1の値を持つ32個の小さなデータ空間)を例にします。最初に、32ビットの全てを0で初期化します。
ここにデータを1件登録するとき、ブルームフィルタは複数の「ハッシュ関数」を使って、データからいくつかのマス目番号を計算します。仮に3つの位置を計算する設定(ハッシュ数3)にしてみましょう。データを入れるときは、計算された3つのビットを1に書き換えます。元のデータについては記録しません。
なお、ハッシュ関数とは、任意のデータから一定のルールで数値(ハッシュ値)を弾き出す計算処理のことです。同じデータからは必ず同じ数値が得られ、異なるデータからは異なるハッシュ値が得られるように設計されていますが、同じハッシュ値になる(衝突する)可能性もあります。このハッシュ値をビット配列のサイズで割った余りなどを求めることで、データに対応する数値を求めることができます。
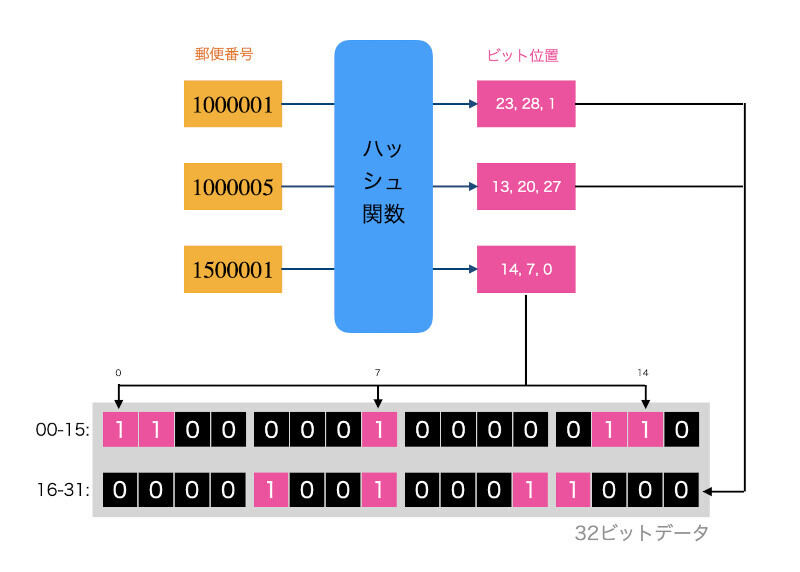
言葉だけではイメージしづらいと思いますので、今回作成するプログラムと同じハッシュ計算を使って、実際に32ビット・ハッシュ数3の小さなブルームフィルタへ郵便番号を3件登録した実測例を見てみましょう。
- "1000001"を登録 → 位置: 23, 28, 1
- "1000005"を登録 → 位置: 13, 20, 27
- "1500001"を登録 → 位置: 14, 7, 0
この3件の郵便番号を登録し終えると、32ビットデータの0, 1, 7, 13, 14, 20, 23, 27, 28のビットが1になります。複数のデータで同じ位置が重なることもありますが、すでに1になっている場所はそのまま1にしておきます。登録後の32ビットの並び(位置0〜31)を先頭から順番に書き出すと、次のようになります。
-
ブルームフィルタに3つの値を登録したところ

次に、その郵便番号が登録されているかを調べてみましょう。調べたい郵便番号から同じように3つのハッシュ位置を計算し、その3か所のビットがすべて1になっているかを確認します。
未登録の"1000000"という番号を調べてみましょう。ハッシュ計算を行うと、位置は 10, 19, 28です。それで、ビット列の10番目、19番目、28番目を確認すると、28番目は"1000001"を登録したときに1になっていますが、10番目と19番目は0のままです。もし "1000000"が過去に一度でも登録されていたなら、10番目も19番目も必ず1になっているはずです。それで、1か所でも0が見つかった時点で、登録されていないことが分かるのです。
では、もうひとつ未登録の"1000004"という番号を調べてみたらどうなるでしょうか。ハッシュ計算を行うと、位置は 27, 14, 1と出ました。ビット列を確認してみると、それぞれ別のデータを登録したときに偶然すべて1に書き換えられてしまっています。
ブルームフィルタは元の文字列を保存していないため、この3か所が1つのデータによって立てられた旗なのか、別々のデータが偶然重なって立てられた旗なのかを区別できません。そのため、3か所すべてが1だった場合は「登録されているかもしれない」という判定になります。実際には、"1000004"は未登録なので、これはたまたま他のデータのビットと重なって起きたものです。このように、本当は存在しないのに「あるかも」と判定してしまう現象を偽陽性(False Positive)と呼びます。
そのため、ブルームフィルタは、「絶対にない」ことを判定できますが、絶対にあることは判定できないという欠点があるのです。しかし、冒頭で紹介したWebブラウザの危険URLの判定などの用途においては、省メモリで高速に危険URLに登録されていないことを確認できます。


Rustプロジェクトの作成と郵便番号データの準備
それでは、実際にRustでブルームフィルタを実装し、日本の全郵便番号データを使ってその威力を確かめてみましょう。
まずはターミナルを開き、以下のコマンドで新しいプロジェクトを作成しましょう。
mkdir rust_bloom
cd rust_bloom
cargo init
次に、登録・検証用のデータとして、本連載の23回目でも使用した日本郵便の郵便番号データ(UTF-8版「utf_ken_all.csv」)をプロジェクトのルートディレクトリに配置します。CSVファイルは、こちらからダウンロードできます。ZIPファイルをダウンロードしたら解凍してプロジェクトにコピーしましょう。
プロジェクトのファイル配置は次のようになります。
.
├── Cargo.toml
├── src
│   └── main.rs
└── utf_ken_all.csv
準備ができたら「src/main.rs」にプログラムを書いていきましょう。
ブルームフィルタを実装しよう
今回のプログラムは、大きく分けて「ブルームフィルタのデータ構造と初期化」「ダブルハッシングによる登録と検索」「郵便番号CSVを使った実験(メイン処理)」の3つのパートで構成されています。
プログラム全体は、こちらにアップロードしましたので、全体はそちらを確認してください。
データ構造の定義と最適パラメータの計算を記述しよう
まずは、ブルームフィルタの構造体「BloomFilter」の定義と、期待するデータ件数や目標の偽陽性率から最適なサイズを自動計算するnewメソッドの定義部分を見てみましょう。
use std::collections::HashSet;
use std::hash::{Hash, Hasher};
use std::collections::hash_map::DefaultHasher;

/// ブルームフィルタ --- (※1)
struct BloomFilter {
    bits: Vec<u64>,   // ビット配列
    num_bits: usize,  // ビット数
    num_hashes: usize, // ハッシュの個数
}

impl BloomFilter {
    /// 期待要素数 n と目標の偽陽性率 p から作る --- (※2)
    fn new(n: usize, p: f64) -> Self {
        // m = -n * ln(p) / (ln2)^2
        let m = (-(n as f64) * p.ln() / (2f64.ln().powi(2))).ceil() as usize;
        // k = (m / n) * ln2
        let k = ((m as f64 / n as f64) * 2f64.ln()).round().max(1.0) as usize;
        Self {
            bits: vec![0u64; m.div_ceil(64)],
            num_bits: m,
            num_hashes: k,
        }
    }
…省略…
上記、(※1)では、ブルームフィルタの構造体BloomFilterを定義します。構造体が持つフィールドはたった3つです。
1つ目の 「bits: Vec
2つ目の 「num_bits」 はビット配列全体の総ビット数、3つ目の 「num_hashes」 は1つのデータにつき何箇所のビットを立てるかを表すハッシュ関数の個数です。
(※2)では、期待要素数nと目標偽陽性率pからビット数とハッシュ数を決定します。ブルームフィルタを作るとき、登録する予定のデータ件数と、許容できる勘違いの確率(目標偽陽性率)の2つが決まれば、メモリ効率が良くなるビット数とハッシュ数を計算から導き出すことができます。
ダブルハッシングと要素の登録・検索を実装しよう
続いて、データからビット位置を計算するhashesメソッドと、実際にビットを立てる addメソッド、そしてビットを調べるcontainsメソッドの定義を見てみましょう。
…省略…
    /// 2つのハッシュ値を返す(ダブルハッシング用) --- (※3)
    fn hashes(item: &str) -> (u64, u64) {
        let mut h1 = DefaultHasher::new();
        item.hash(&mut h1);
        let mut h2 = DefaultHasher::new();
        // 2本目は入力に印を付けて別の値にする
        (item, 0x9e3779b97f4a7c15u64).hash(&mut h2);
        (h1.finish(), h2.finish() | 1) // h2は奇数にして周期を避ける
    }

    /// 要素を登録する --- (※4)
    fn add(&mut self, item: &str) {
        let (h1, h2) = Self::hashes(item);
        for i in 0..self.num_hashes {
            let pos = (h1.wrapping_add((i as u64).wrapping_mul(h2)) as usize) % self.num_bits;
            self.bits[pos / 64] |= 1u64 << (pos % 64);
        }
    }

    /// 要素があるかも知れないか調べる --- (※5)
    fn contains(&self, item: &str) -> bool {
        let (h1, h2) = Self::hashes(item);
        for i in 0..self.num_hashes {
            let pos = (h1.wrapping_add((i as u64).wrapping_mul(h2)) as usize) % self.num_bits;
            if self.bits[pos / 64] & (1u64 << (pos % 64)) == 0 {
                return false; // 1つでも0なら「絶対にない」
            }
        }
        true // 全部1なら「あるかも」
    }

    /// ビット配列のバイト数
    fn size_bytes(&self) -> usize {
        self.bits.len() * 8
    }
}
…省略…
(※3)では、ダブルハッシング用の2つのハッシュ値を生成します。後述する郵便番号の実験のように偽陽性率を1%(「p = 0.01」)に設定すると、ハッシュ数 「k」 は7になり、1つのデータから7つの異なるビット位置を求める必要があります。しかし、互いに独立した別々のハッシュ関数を7種類も用意したり、長い文字列に対して毎回7回もゼロからハッシュ計算を繰り返したりするのは、実装も大変ですし計算時間もかかってしまいます。
そこでブルームフィルタの実装で広く使われているのが、「ダブルハッシング(Double Hashing)」と呼ばれるテクニックです。これは2つの独立したハッシュ値 「h1」 と 「h2」 だけを計算し、i番目(0からk-1)のハッシュ値を 「h1 + i * h2」という一次式で合成するという工夫です。これなら最初の2回だけハッシュ計算を行えば、あとは単純な足し算と掛け算だけでいくつでもビット位置を量産できます。
今回は、Rust標準ライブラリの 「DefaultHasher」 を2つ作って 「h1」 と 「h2」 を計算しています。1つ目の 「h1」 には文字列をそのまま流し込み、2つ目の 「h2」 には同じ文字列から別のハッシュ値を得るために、黄金比に由来する定数 「0x9e3779b97f4a7c15u64」 を組にしたタプルをハッシュ化しています。さらに戻り値のタプルでは、「h2.finish() | 1」 として2つ目の値の最下位ビットを強制的に1(奇数)にしています。「h2」とビット配列のサイズ「m」が互いに素であれば、位置を一巡できます。「h2」を奇数にするだけでは、mが偶数の場合でも同じ場所を短い周期で循環する可能性があります。
(※4)では、要素をビット配列に登録します。addメソッドでは、まずSelf::hashes(item)で2つのハッシュ値 「(h1, h2)」 を取得し、位置posを計算して順番にビットを1にします。
(※5)では、要素が存在するかを判定するcontainsメソッドを定義します。containsメソッドは、addメソッドと同じ手順で、その場所のビットが1か0かを順番に検査します。
郵便番号データを登録して動作を検証してみよう
最後に、「utf_ken_all.csv」 を読み込んでブルームフィルタに登録し、本当に見逃し(偽陰性)がゼロなのか、そして0000000〜9999999の全1,000万通りをぶつけたときに偽陽性が設計どおり約1%に収まるのかを検証してみましょう。
…省略…
fn main() {
    // 郵便番号CSVを読み、3列目にある郵便番号を取得 --- (※6)
    let path = std::env::args().nth(1).unwrap_or_else(|| "utf_ken_all.csv".to_string());
    let text = std::fs::read_to_string(&path).expect("CSVが読めません");
    let mut exact: HashSet<String> = HashSet::new();
    for line in text.lines() {
        let cols: Vec<&str> = line.split(',').collect();
        if cols.len() > 2 {
            let code = cols[2].trim_matches('"').trim();
            if code.len() == 7 && code.chars().all(|c| c.is_ascii_digit()) {
                exact.insert(code.to_string());
            }
        }
    }
    println!("登録した郵便番号: {}件", exact.len());

    // 偽陽性率1%でブルームフィルタを作り、全件登録 --- (※7)
    let mut bloom = BloomFilter::new(exact.len(), 0.01);
    for code in &exact {
        bloom.add(code);
    }
    println!(
        "ビット数 m={} ({}バイト = {:.1}KB), ハッシュ数 k={}",
        bloom.num_bits,
        bloom.size_bytes(),
        bloom.size_bytes() as f64 / 1024.0,
        bloom.num_hashes
    );

    // 実験1: 登録済みは見逃さないか(偽陰性チェック) --- (※8)
    let mut missed = 0usize;
    for code in &exact {
        if !bloom.contains(code) {
            missed += 1;
        }
    }
    println!("-------------------------------------------------");
    println!("★実験1★ 見逃し(偽陰性): {}件", missed);
上記(※6)では、郵便番号CSVを読み込み、重複のない一覧を作ります。日本郵便のCSVファイル(utf_ken_all.csv)は、1行がカンマ区切りになっており、先頭から3列目(インデックス 2)に "1000001" のようにダブルクォーテーション付きで7桁の郵便番号が入っています。
なお、1つの郵便番号が複数の町域に分かれて複数行にわたって記載されているケースがあるため、まずは正解データとなる exact: HashSet
(※7)では、目標偽陽性率1%でブルームフィルタを作成し、全件登録します。
(※8)では、登録済みの郵便番号を1件でも見逃さないか(偽陰性チェック)を行います。登録したすべての郵便番号に対して、bloom.contains(code)を実行し、見逃し(偽陰性)判定がないかを全件チェックします。ブルームフィルタのアルゴリズムが正しく実装されていれば、このmissedは必ず0になるはずです。
続いて、全件をチェックして偽陽性の数を数えてみましょう。
    ...省略...
    // 実験2: 0000000〜9999999 の全数チェックで偽陽性を数える --- (※9)
    let start = std::time::Instant::now();
    let mut false_positive = 0usize;
    for n in 0..10_000_000u32 {
        let code = format!("{:07}", n);
        if bloom.contains(&code) {
            if !exact.contains(&code) {
                false_positive += 1;
            }
        }
    }
    let negatives = 10_000_000 - exact.len();
    let r = false_positive as f64 / negatives as f64 * 100.0;
    println!("-------------------------------------------------");
    println!("★実験2★ 偽陽性率: {:.4}%", r);
    println!("-------------------------------------------------");
    println!("全数チェック所要時間: {:?}", start.elapsed());
}
(※9)では、0000000〜9999999の全1,000万通りを検査し、偽陽性を数えます。7桁の郵便番号としてあり得るすべての組み合わせは、「0000000」 から 「9999999」 までのちょうど1,000万通りです。この1,000万通りすべてをループで生成し、まず第1段階として 「bloom.contains(&code)」 にかけます。
全1,000万通りから実在する郵便番号の件数を引いた「実在しない郵便番号の総数(「negatives」)」に対して、どれだけの割合で偽陽性が発生したかを計算し、設計目標の1%と一致するかを確認します。最後に、「HashSet
実行結果を確認してみよう
プログラムが完成したら、1,000万回のループを高速に実行するため、「--release」 オプションを付けてリリースビルドで実行してみましょう。
cargo run --release
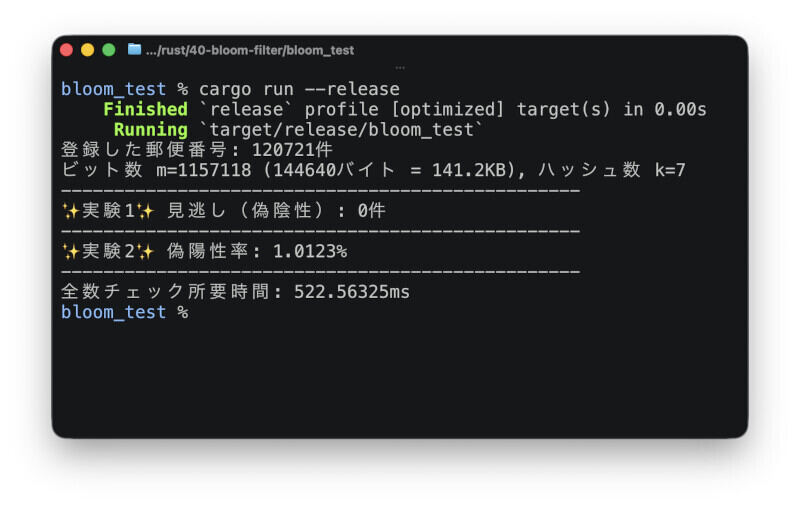
実行すると、次のように判定結果が出力されます。
-
ブルームフィルタで郵便番号を判定したところ

結果を見ると、思った通りの性能が出ていることがわかります。
日本の全郵便番号12万件(3.7MBのデータサイズ)を登録するためにブルームフィルタが使ったメモリは、わずか144,640バイト(約141KB)でした。実際にはハッシュテーブルのバケット管理領域やメモリアロケータのオーバーヘッドがさらに加わりますが、文字列データが最低限必要とするメモリ量と比べるだけでも、ブルームフィルタを使うことで、約26分の1以下のメモリ量で収まります。
まとめ
以上、ブルームフィルタを実装して、その仕組みを確認しました。もちろん、7桁の郵便番号の例では、それほどその便利さが実感できなかったかもしれません。しかし、母集団のサイズが大きい場合や長めの文字列を多数登録する場合には、ブルームフィルタの実力が光ります。それでも、ブルームフィルタは、その仕組み上、後から要素を削除できなかったり、データの登録件数の概数が分かっている必要があったり、そもそも「ない」ことを確認することしかできなかったりと使い所が難しい場合もあります。とは言え、このように用途を限定することで、大きくパフォーマンスを向上させることができるのが、アルゴリズムの面白いところです。
自由型プログラマー。くじらはんどにて、プログラミングの楽しさを伝える活動をしている。代表作に、日本語プログラミング言語「なでしこ」 、テキスト音楽「サクラ」など。2001年オンラインソフト大賞入賞、2004年度未踏ユース スーパークリエータ認定、2010年 OSS貢献者章受賞。これまで50冊以上の技術書を執筆した。直近では、「大規模言語モデルを使いこなすためのプロンプトエンジニアリングの教科書(マイナビ出版)」「Pythonでつくるデスクトップアプリ(ソシム)」「実践力を身につける Pythonの教科書 第2版」「シゴトがはかどる Python自動処理の教科書(マイナビ出版)」など。


 パスワードを変更してもGmailを盗み見? マルウェア「Remus」が新機能を宣伝