AIによるバイブコーディング全盛の時代になっても、便利なアルゴリズムを知っているかどうかで大きく成果が変わってきます。今回紹介するのは「トライ木(Trie)」です。トライ木を使うと、高速に自動補完機能を実現できます。トライ木の仕組みを理解し、Rustでトライ木を実装して、簡単な英単語の補完機能を作ってみましょう。
-
トライ木を使って高速な文字列検索

「トライ木 (Trie)」とは
トライ木は、文字列の共通する部分をまとめて管理するデータ構造です。特に、入力した文字列で始まる単語を高速に探す「前方一致検索」が得意です。検索エンジンの入力候補、エディターのコード補完、辞書検索、コマンドの自動補完など、身近なところで応用できます。
その仕組みは単純です。例えば、「apple」「application」「apply」という3つの単語は、先頭の「appl」が共通しています。トライ木では、この共通部分を1つにまとめ、異なる部分を枝分かれさせて管理します。
例えば、「app」「apple」「apply」「api」「bat」「bag」という6つの単語をトライ木に登録すると、次のような構造になります。
-
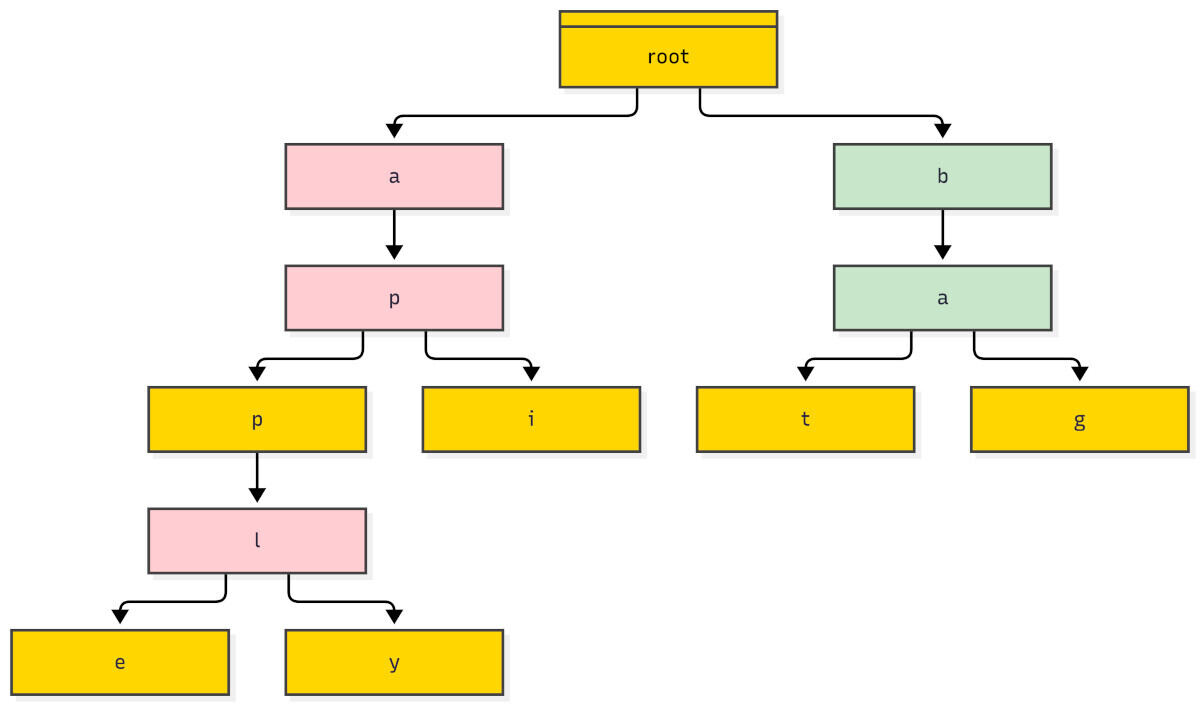
トライ木の構造について

このように単語を木構造で管理することで、最初からすべての単語を調べる必要がなくなります。例えば、「app」と入力されたら、「a」→「p」→「p」と木をたどるだけで、候補となる単語を効率よく探せるのです。
これを応用することで、補完機能を作ることができます。例えば、英単語の検索であれば、検索ボックスに「app」と入力すると、「app」に続く候補として「apple」「apply」などの候補を提示することができます。
もちろん、もともと数百件の候補しかないのであれば、ほとんど検索に時間はかかりませんが、何万件、何百万件といった大量の候補がある場合には、トライ木のアルゴリズムを使うことで、高速な単語検索が可能になります。
今回は、Rustでトライ木をゼロから実装し、英単語を入力すると候補が表示される自動補完ツールを作ってみましょう。さらに、普通の文字列検索と処理速度を比較して、トライ木の実力を確かめてみます。
Rustのプロジェクトを作ろう
それでは、Rustのプロジェクトを作成しましょう。プロジェクトを作成するには、ターミナル(WindowsならPowerShell、macOSならターミナル.app)を起動して、次のコマンドを入力します。
# プロジェクトのフォルダを作成
mkdir trie_test
cd trie_test
# Cargoでプロジェクトを初期化
cargo init
# JSONファイルの読み取りパッケージを追加
cargo add serde_json
すると、Rustのプロジェクトのひな形が生成されます。そして、今回英単語データとして、こちらにあるパブリックドメインの英和辞書データを利用します。今回は、JSON形式(ZIPファイル)をダウンロードして、アーカイブを解凍します。
以下のようなファイルの配置にします。
<プロジェクトのルート>
├── Cargo.toml … Rustのプロジェクト管理ファイル
├── ejdict.json … 英和辞書のデータ
└── src
    └── main.rs … メインファイル
トライ木で補完機能を作ってみよう - データ構造の定義
この中の「main.rs」を編集します。完成版のプログラムは、こちらで確認できます。
ここでは、プログラムを少しずつ確認していきましょう。まず最初に、Rustでトライ木のデータ構造を宣言する部分を確認してみましょう。
use std::collections::BTreeMap;
use std::collections::HashMap;

/// 候補の最大件数 --- (※1)
const MAX_RESULTS: usize = 50;

/// トライ木のノード --- (※2)
#[derive(Default)]
struct Node {
    children: BTreeMap<char, Node>,
    word: Option<String>,
}

/// トライ木(Trie) --- (※3)
#[derive(Default)]
struct Trie {
    root: Node,
}
トライ木は、文字を1つずつつなげた木構造で単語を管理します。
まず、(※1)では検索結果の最大件数を50件に設定しています。大量の単語が一致する場合でも、表示する候補を制限するためです。
次に、(※2)で定義しているNode構造体は、トライ木を構成する1つのノードを表します。childrenには次の文字と子ノードの対応を保存し、wordには、そのノードで単語が完成する場合に単語全体を保存します。
ここで、childrenにはBTreeMap
最後に、(※3)のTrie構造体で、木の起点となるルートノードを管理します。「#[derive(Default)]」は、各構造体の初期値を自動生成するための指定です。
トライ木に単語を登録しよう
続いて、トライ木に単語を登録する処理を作成します。Rustで次のように、「impl Trie { ... }」と書くと、構造体Trieにメソッドを記述できます。
impl Trie {
    fn new() -> Self { // 空のトライ木を作成 --- (※4)
        Self::default()
    }

    /// 単語を1つ登録する --- (※5)
    fn insert(&mut self, word: &str) {
        let mut node = &mut self.root;
        // 1文字ずつ辿り、なければ子ノードを作る --- (※6)
        for c in word.chars() {
            node = node.children.entry(c).or_default();
        }
        // 最後のノードに単語を記録する
        node.word = Some(word.to_string());
    }
    …続く…
(※4)のnewメソッドは、空のトライ木を作成します。Self::default()を呼び出すことで、ルートノードが初期化されます。
(※5)のinsertメソッドは、指定された単語をトライ木に登録するものです。引数の&strは文字列への参照を表し、&mut selfはトライ木を変更することを意味します。
そして、(※6)のfor文では、word.chars()を使って単語を1文字ずつ取り出して、子ノードに文字を追加します。特に重要なのが、次の部分です。
node = node.children.entry(c).or_default();
これは、entry(c)で文字cに対応する子ノードを調べ、存在しなければor_default()で新しいノードを作成します。すでに存在する場合は、そのノードをそのまま利用します。
例えば、catとcarを登録すると、先頭のcaまでのノードを共有し、最後のtとrで枝分かれします。このように共通部分をまとめられることが、トライ木の特徴です。最後にnode.wordに、単語が完成するノードに文字列を保存します。
入力した文字列から候補を検索しよう
次に、入力された文字列で始まる単語を検索して単語一覧を取り出すメソッドsuggestの定義を見てみましょう。
impl Trie {
    …省略…
    /// 入力で始まる単語を返す --- (※7)
    fn suggest(&self, input: &str) -> Vec<&str> {
        // 1. 入力した文字列の分だけ、根から辿る
        let mut node = &self.root;
        for c in input.chars() {
            match node.children.get(&c) {
                Some(next) => node = next,
                // 途中で道が途切れたら、候補なし
                None => return Vec::new(),
            }
        }
        // 2. そのノード以下の単語を集める --- (※8)
        let mut results = Vec::new();
        Self::collect(node, &mut results);
        results
    }

    /// ノード以下の単語を深さ優先で集める --- (※9)
    fn collect<'a>(node: &'a Node, results: &mut Vec<&'a str>) {
        if results.len() >= MAX_RESULTS { // MAX_RESULTS件で打ち切り
            return;
        }
        // このノードで終わる単語があれば追加
        if let Some(word) = &node.word {
            results.push(word);
        }
        // 子ノードを順に辿る
        for child in node.children.values() {
            Self::collect(child, results);
        }
    }
}
(※7)のsuggestメソッドは、入力した文字列に一致する候補を取得するものです。戻り値のVec<&str>は、文字列の参照をまとめた可変長配列です。
まず、ルートノードから始め、入力文字列を1文字ずつ調べます。入力文字列inputを1文字ずつfor構文で処理します。node.children.get(&c)によって、次の文字に対応する子ノードが存在するか確認していきます。存在する場合はSome(next)となり、そのノードへ移動します。一方、存在しない場合はNoneとなり、一致する単語がないので空の配列を返します。
入力した文字列に対応するノードまで到達すると、(※8)でcollectメソッドを呼び出します。これにより、そのノード以下に登録されている単語をすべて集めます。
(※9)のcollectメソッドでは、再帰処理を使って単語を集めます。最初に、検索結果がMAX_RESULTS件に達しているか確認し、上限に達した場合は処理を終了します。次に、現在のノードに単語が保存されていれば、results.push(word)で候補に追加します。そして、node.children.values()で子ノードを順に取り出し、Self::collectを再帰的に呼び出します。
なお、fn collect<'a>の'aは「ライフタイム」と呼ばれるRust特有の仕組みです。ここでは、検索結果に保存する文字列の参照が、元のノード内の文字列より長く使われないように、参照の関係を明示しています。
また、子ノードにはBTreeMapを使っているため、候補は辞書順に集められます。
コマンドライン引数と辞書を読み込もう
最後に、プログラム本体のメイン処理を確認しましょう。コマンドライン引数を得て、英単語を辞書データから読み出しトライ木に登録し、検索結果を表示します。
fn main() {
    // コマンドライン引数から入力を取得 --- (※10)
    let input = match std::env::args().nth(1) {
        Some(s) => s,
        None => {
            eprintln!("使い方: trie_test <単語の先頭>");
            return;
        }
    };

    // 辞書ファイル(JSON)を読み込む: {"英単語": "和訳"} --- (※11)
    let text = std::fs::read_to_string("ejdict.json").expect("ejdict.jsonが読めません");
    let dict: HashMap<String, String> = serde_json::from_str(&text).expect("JSONの解析に失敗");

    // 全単語をトライ木に登録 --- (※12)
    let mut trie = Trie::new();
    for word in dict.keys() {
        trie.insert(word);
    }

    // 候補を表示(和訳も添える) --- (※13)
    for word in trie.suggest(&input) {
        let mean: String = dict[word].chars().take(22).collect();
        println!("{:<15} : {}", word, mean);
    }
}
(※12)では、Trie::new()で空のトライ木を作成します。そして、dict.keys()で辞書に登録されている英単語を順番に取り出し、trie.insert(word)で登録していきます。
ここでは和訳をトライ木に保存せず、英単語だけを登録している点がポイントです。これにより、トライ木は単語の検索に専念し、和訳の取得はHashMapが担当します。
(※13)では、trie.suggest(&input)で入力した文字列から始まる単語を取得します。そして、dict[word]で和訳を取り出し、chars().take(22).collect()によって、先頭22文字に短縮します。最後に、println!("{:<15} : {}", word, mean)で英単語を左寄せで表示し、その右側に和訳を表示します。「{:<15}」は、表示幅を最低15文字分確保する書式指定です。
実行してみよう
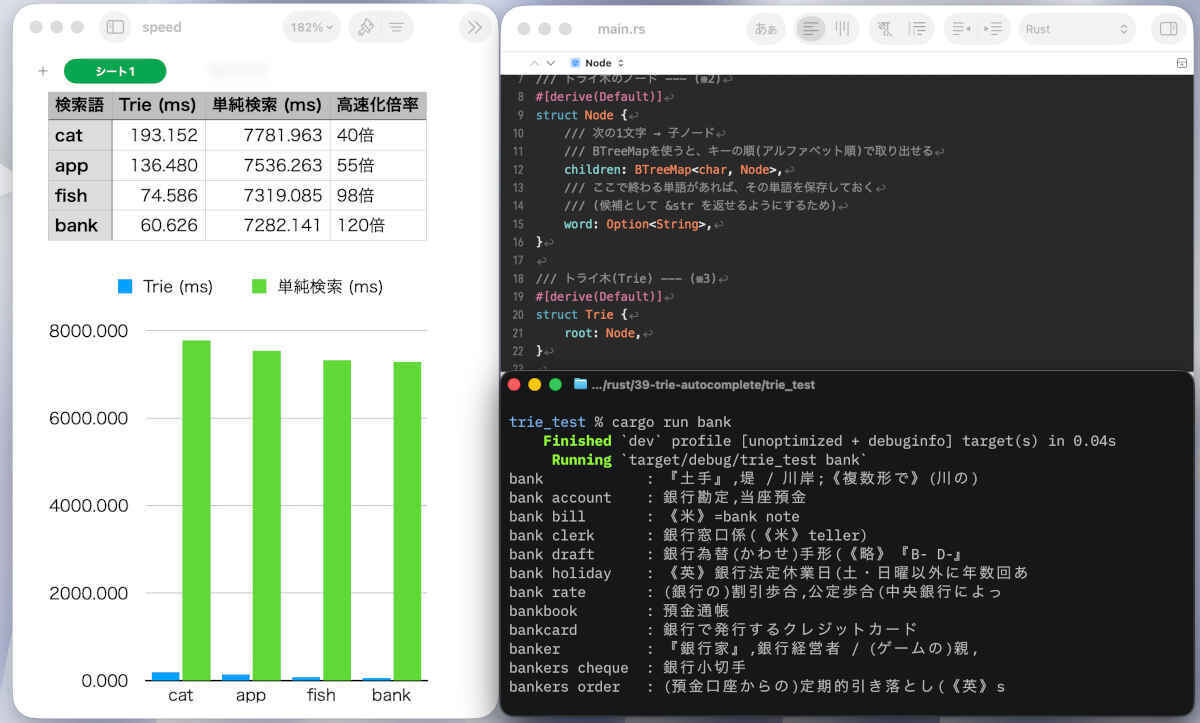
それでは、プログラムを実行してみましょう。ターミナルで、次のようなコマンドを実行します。すると、「bank」から始まる英単語が表示されます。
# bankを検索して表示
cargo run bank
次の画面は実行したところです。

単純検索とトライ木で速度比較してみよう
今回読み込んだ英単語データは、47000語程度の単語数を持つデータです。これを、トライ木を使わず1万回繰り返し検索するものと、トライ木を使ったものを比較してみました。表にすると次の通りです。単語によって速度は異なりますが、だいたい40倍から120倍の差が出ました。やはりトライ木を使うと速いですね。
| 検索語 | Trie (ms) | 単純検索 (ms) | 高速化倍率 |
|---|---|---|---|
| cat | 193.152 | 7781.963 | 40倍 |
| app | 136.480 | 7536.263 | 55倍 |
| fish | 74.586 | 7319.085 | 98倍 |
| bank | 60.626 | 7282.141 | 120倍 |
グラフにすると次のようになります。このように確認すると圧倒的な速度差があることが分かります。


-
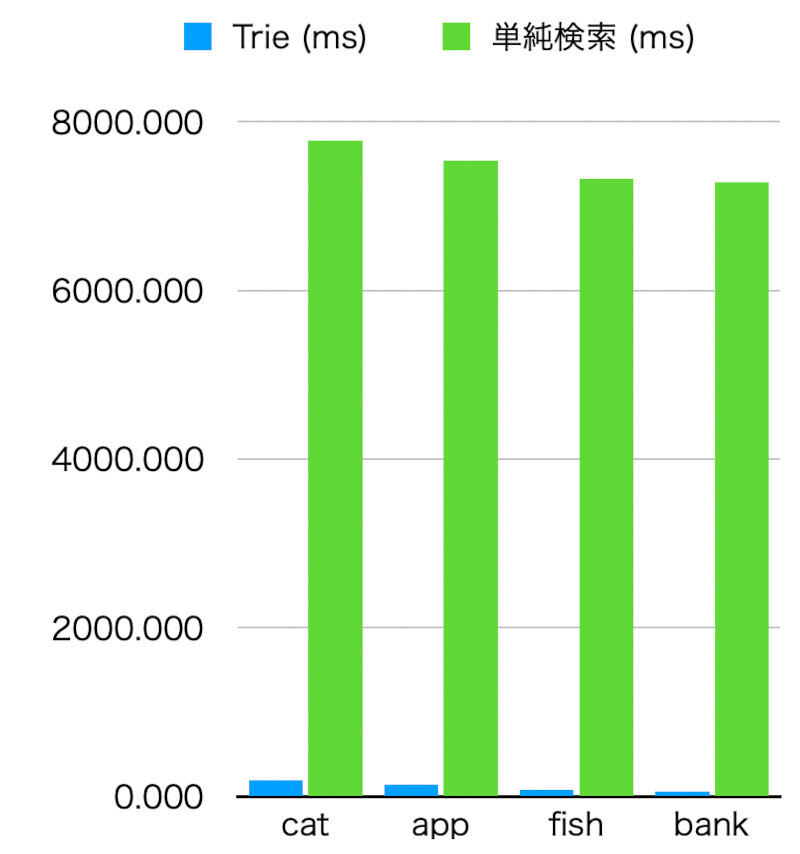
トライ木と単純な文字列検索の比較をグラフにしたところ

まとめ
以上、今回は、トライ木のアルゴリズムを実装して、英単語の検索を行うプログラムを作ってみました。今回紹介したようにトライ木の仕組みはとても簡単なものですが、実行結果を見ると、圧倒的な速度が出ていることを確認できました。自動補完などを実装するのに役立つことが分かるでしょう。
自由型プログラマー。くじらはんどにて、プログラミングの楽しさを伝える活動をしている。代表作に、日本語プログラミング言語「なでしこ」 、テキスト音楽「サクラ」など。2001年オンラインソフト大賞入賞、2004年度未踏ユース スーパークリエータ認定、2010年 OSS貢献者章受賞。これまで50冊以上の技術書を執筆した。直近では、「大規模言語モデルを使いこなすためのプロンプトエンジニアリングの教科書(マイナビ出版)」「Pythonでつくるデスクトップアプリ(ソシム)」「実践力を身につける Pythonの教科書 第2版」「シゴトがはかどる Python自動処理の教科書(マイナビ出版)」など。



 Windows 11 26H2、リリースからわずか2週間で新機能に不具合